Wer sieht noch nach, was eine Maschine ausgibt? Und was kostet es künftig, sie laufen zu lassen? Beide Fragen haben diese Woche eine Antwort bekommen, an weit auseinanderliegenden Stellen.
Für KI in der Technischen Dokumentation gab es diese Woche keine eigene Meldung. Ich sehe die Antworten trotzdem dort, wo auch eine Redaktion arbeitet: an der Stelle, an der ein Mensch für ein maschinelles Ergebnis geradesteht.
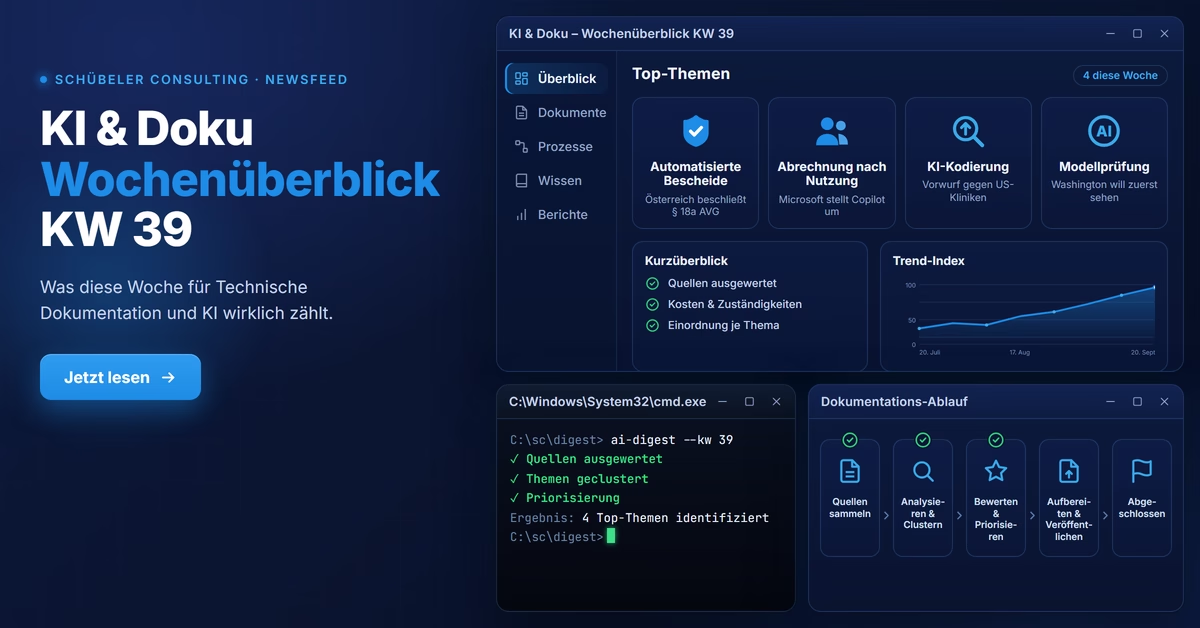
Österreichs Nationalrat gibt Bescheide ohne menschliche Prüfung frei
Der österreichische Nationalrat hat am Mittwoch, dem 23. September, Gesetzesnovellen zur Automatisierung von Verwaltungsbescheiden beschlossen, getragen von der Koalition aus ÖVP, SPÖ und NEOS. Der neue § 18a des Allgemeinen Verwaltungsverfahrensgesetzes soll Behörden erlauben, erstinstanzliche schriftliche Bescheide vollständig automatisiert zu erlassen, auch bei bestimmten Verwaltungsstrafen. Voraussetzung ist, dass die Sache „im Hinblick auf den maßgeblichen Sachverhalt, die zu lösenden Rechtsfragen und den Stand der Technik für eine vollständig automatisierte schriftliche Erledigung geeignet“ ist. Die Zustimmung des Bundesrates, der österreichischen Länderkammer, gilt als Formsache. Die FPÖ nennt die Vorschriften „zu unbestimmt, zu weitreichend und verfassungsmäßig fragwürdig“, die Grünen bemängeln die ungeklärte Verantwortung für Fehler und dass die Behörden selbst über den Einsatz bestimmen (Quelle).
Ein Bescheid ist ein Dokument, das seine Entscheidung begründen muss. Genau diese Begründung ist die Stelle, an der ein Sprachmodell plausibel klingt und danebenliegt. Der Einwand der Grünen trifft deshalb den Kern. Anfechten lässt sich eine automatisierte Begründung nur, wenn nachvollziehbar ist, woran sie entstanden ist. Das Gesetz knüpft die Zulässigkeit an die Eignung der Sache, gemessen an Sachverhalt, Rechtsfragen und Stand der Technik; wo automatisiert wird, entscheidet nach der Meldung jede Verwaltungseinheit für sich selbst. Dem Empfänger bleibt die Begründung; woran sie entstanden ist, muss er glauben.
Microsoft rechnet Copilot künftig nach Nutzung ab
Microsoft ordnet die Copilot-App neu: Home steht für Chat und Zusammenarbeit, Code richtet sich an Nicht-Entwickler, und Autopilot ist ein Agent „mit eigenem Cloud-Computer und Identität“. Bei der Abrechnung wechselt das Modell: Für Autopilot, Code und Cowork setzt Microsoft auf „nutzungsbasierte Abrechnung“. Die bisherige Pauschale entfällt dort, und die reguläre Copilot-Lizenz deckt nur noch Chat und die Integrationen in die Office-Apps ab. Autopilot startet Ende September als private Vorschau, Home und Code folgen in den kommenden Wochen über Microsofts Frontier-Programm; für Abonnenten von Microsoft 365 Premium und Pro soll Code später im Jahr verfügbar sein. Bei den Office-Integrationen entscheidet künftig ein Auto-Router, welches Modell eine Anfrage bearbeitet, nach „Genauigkeit, Geschwindigkeit und Kosten“ (Quelle).
Für eine Redaktion ist das die folgenreichste Meldung der Woche, auch wenn sie nach Produktpflege aussieht. Eine Pauschale macht den Einsatz kalkulierbar: Man probiert aus, was geht, und die Rechnung bleibt gleich. Verschiebt sich das Limit einer Pauschale, merkt man das wenigstens an einem Datum. Bei nutzungsbasierter Abrechnung kostet jeder Versuch, und wie viele Versuche ein Agent braucht, um eine Anleitung umzuschreiben, zeigt sich erst hinterher. Aus einem Werkzeug, das man einfach einsetzt, wird eines, dessen Einsatz man begründen muss. Das ändert, wer darüber entscheidet.
Vor dieser Frage steht jede Redaktion, die Copilot nutzt: Welche Arbeiten laufen künftig über die Pauschale, welche werden einzeln abgerechnet? Den Ausschlag gibt, ob sich eine Nutzung einem Vorgang zuordnen lässt. Eine Übersetzung je Modul lässt sich einem Vorgang zuordnen und damit rechnen. Ein Agent, der eine Woche lang im Bestand sucht, gehört zu keinem einzelnen Vorgang; was er kostet, hängt daran, wie geordnet der Bestand ist. Bleibt die Frage offen, kommt die Antwort mit der ersten Rechnung.
Ein Versicherungsverband wirft Kliniken KI-gestützte Mehrabrechnung vor
Der Versicherungsverband Blue Cross Blue Shield Association wirft Krankenhäusern vor, mit KI-gestützter Kodierung binnen 2 Jahren knapp eine Milliarde Dollar Mehrkosten verursacht zu haben, im Schnitt fast 12.000 Dollar je Fall ohne erkennbar andere Behandlung. Der Klinikverbund McLaren Health Care nimmt mit der Software von SmarterDx eine Million Dollar mehr im Monat ein — die Zahl nennt sein Finanzchef Dave Mazurkiewicz, und der Anbieter ist an diesen Mehreinnahmen beteiligt. Beide Zahlen stammen aus einem Bericht vom 25. September. Derselbe Bericht rechnet Pauschale und Verbrauch gegeneinander: Ein voll ausgereizter Pro-Zugang bei ChatGPT für 200 Dollar im Monat entspricht nach einer Rechnung von SemiAnalysis bis zu 14.000 Dollar zu den Listenpreisen der Schnittstelle. Beim gleich teuren Claude Max sind es bis zu rund 8.000 Dollar (Quelle).
Bemerkenswert ist an der Kodierung, worauf die Software ausgelegt ist. Sie erhöht die Forderung, und ihr Anbieter verdient an der Erhöhung mit. Ich sehe in diesem Aufbau niemanden, der ein eigenes Interesse daran hätte, die höhere Kodierung zu prüfen. Wer ein Werkzeug am Ergebnis beteiligt, ändert damit seine Richtung.
Das Siebzigfache. So weit liegen Pauschale und Listenpreis im Extremfall auseinander, und die Gelegenheitsnutzer bezahlen diese Spanne für die Vielnutzer mit. Das trägt, solange die meisten wenig nutzen, und kippt, sobald Agenten im Hintergrund arbeiten. Ich lese Microsofts Umstellung vor diesem Hintergrund; die Quelle stellt die Verbindung nicht selbst her.
Washington will neue Modelle vor der britischen Prüfstelle sehen
Das Weiße Haus hat OpenAI und Anthropic aufgefordert, neue Modelle zuerst der US-Regierung vorzulegen, bevor das britische AI Security Institute sie bekommt; die Anfrage kam aus dem Büro des National Cyber Director, und die Quelle beruft sich dabei auf Politico. Anthropic hat sich offenbar bereits gefügt und sein Modell Claude Mythos 5.1 bisher nur US-Organisationen zugänglich gemacht. Das Institut galt bisher als eine der am besten ausgestatteten staatlichen Prüfstellen weltweit und hatte frühen Zugang zu den Modellen führender Labore. Über die US-Seite hält der Bericht fest, das Center for AI Standards and Innovation arbeite „ohne festen Direktor und mit nur wenigen Dutzend Mitarbeitern“ (Quelle).
In derselben Woche, in der ein Parlament das Prüfen von Bescheiden an Maschinen abgeben will, rückt eine Prüfstelle in der Reihenfolge nach hinten. Zweimal dieselbe Stelle, von zwei Seiten her. Unternehmen außerhalb der Vereinigten Staaten trifft daran etwas Praktisches: Berichte unabhängiger Prüfstellen, auf die sich eine Anbieterauswahl stützen kann, entstehen künftig später oder anderswo.
Der Preis des Ausprobierens steigt
Beide Bewegungen dieser Woche treffen denselben Moment: den, in dem jemand ein Ergebnis gegenliest. Er wird seltener. Gleichzeitig bekommt jeder Rechenvorgang ein Preisschild. Zusammen heißt das, dass die Phase des freien Ausprobierens zu Ende geht, bevor die meisten Redaktionen ihre Prüfwege geordnet haben. Diese Ordnung lässt sich jetzt unter ruhigen Bedingungen festlegen oder in einem halben Jahr unter Kostendruck.
Wenn Sie überlegen, wo Sie mit KI in Ihrer Dokumentation oder in Ihrem Wissensbestand anfangen sollen: Schreiben Sie mir. Ich sage Ihnen, was ich in vergleichbaren Unternehmen gesehen habe.